Cuando explico cómo analizar datos pesqueros en mi curso de doctorado "Análisis Avanzado de Datos Pesqueros y Modelización con R", dedico un tiempo especial a dos temas. El primero es la inteligencia artificial y el aprendizaje automático; el segundo, la modelización espacial, temporal y bayesiana. Reuní en dos capítulos de libro el material que preparé para el curso sobre estos dos temas. Los dos capítulos se publicaron en octubre de 2026 en Ziraat, Orman ve Su Ürünleri Alanında Güncel Gelişmeler ve Tematik İncelemeler, un libro de Platanus Publishing.
Construí los dos capítulos de la misma manera. Primero explico por qué hace falta cada método y después lo muestro con un ejemplo en R que funciona de principio a fin. Los datos de los ejemplos son datos simulados que generé con set.seed(). Elegí este camino para no compartir datos brutos, pero construí cada simulación sobre la estructura de un estudio real que hicimos en el Egeo: la pesca de cerco en İzmir, los descartes del arrastre en el Egeo, las nasas para cangrejo azul (Callinectes sapidus) en el arroyo Azmak y la pesquería de atún rojo (Thunnus thynnus) del Mediterráneo oriental. Quien ejecute el código en su propio ordenador obtiene exactamente los resultados del capítulo.
El aprendizaje automático no supera por sí solo a los modelos clásicos
En el primer capítulo comparé métodos de aprendizaje automático, como los bosques aleatorios y los árboles de regresión potenciados, con los modelos clásicos que usamos en pesquerías desde hace años, sobre los mismos datos. Cada vez medí el rendimiento con validación cruzada, es decir, viendo qué tan bien predice el modelo datos que no ha visto.
En el ejemplo de CPUE basado en la pesca de cerco de İzmir, los errores de predicción de los métodos fueron casi idénticos, y el GLM clásico dio el error más bajo. En el ejemplo de descartes del arrastre, el GAM y los dos métodos de árboles volvieron a quedar igualados. En el ejemplo de las nasas para cangrejo azul, al clasificar los lances de "captura alta", la regresión logística (AUC 0,76) terminó ligeramente por delante del bosque aleatorio (0,72).
El mensaje principal del capítulo es este: el aprendizaje automático no es una ventaja que sustituya a la estadística clásica, sino una herramienta que la complementa. Cuando los datos tienen una estructura ordenada, un GLM o un GAM bien construido predice al menos igual de bien y, además, muestra el efecto de cada variable de forma legible. El aprendizaje automático marca la diferencia de verdad cuando las variables interactúan de forma compleja, cuando no conocemos la forma de la relación o cuando trabajamos con datos de muchas dimensiones, como las imágenes.
Usar los dos enfoques a la vez tiene otra ventaja. En el ejemplo del cerco, el GLM consideró no significativa la temperatura superficial del mar, mientras que el bosque aleatorio la situó como la segunda variable más importante después de la clorofila-a. A primera vista parece una contradicción. En realidad, la temperatura no afecta a la captura de forma directa, sino a través de su fuerte relación con la clorofila-a. Cuando el GLM tiene en cuenta la clorofila, a la temperatura no le queda nada que explicar; el bosque aleatorio, en cambio, refleja esa información indirecta en su ranking de importancia. Mirando ambos a la vez leemos la relación con más precisión.
Los grandes modelos de lenguaje aceleran el trabajo, pero necesitan supervisión
En la última parte del capítulo traté los grandes modelos de lenguaje, como ChatGPT, y los agentes de inteligencia artificial capaces de escribir y ejecutar código. En el estudio de Brown y colaboradores publicado en 2026, se encargaron a un agente de inteligencia artificial tareas de modelización habituales en ciencia pesquera, como ajustar una curva de crecimiento. El agente completó las tareas correctamente en algunos intentos, pero sus resultados variaron de un intento a otro.
En el estudio que hice con F. Ozan Düzbastılar vimos un panorama parecido. Le hicimos a ChatGPT 50 preguntas sobre arrecifes artificiales y cinco expertos puntuaron las respuestas. La idoneidad de las respuestas cambió claramente según la instrucción utilizada; las puntuaciones de los expertos quedaron algo por encima del punto medio de una escala de siete puntos. Los dos estudios llevan a la misma conclusión: en manos de alguien que conoce el tema, estas herramientas aceleran el trabajo, pero sin supervisión se vuelven poco fiables. Por eso en el capítulo recomiendo que ningún resultado de inteligencia artificial que vaya a alimentar una decisión de gestión se use sin supervisión experta y verificación independiente.
Los datos pesqueros no son independientes
El segundo capítulo aborda una pregunta que el aprendizaje automático suele dejar en segundo plano: ¿hasta qué punto podemos fiarnos de una estimación? Las observaciones de estaciones cercanas, de años consecutivos o de la misma embarcación se parecen entre sí. Cuando la regresión clásica las trata como independientes, actuamos como si tuviéramos más información de la que realmente tenemos. Los intervalos de confianza se estrechan y un efecto que en realidad no es significativo puede parecerlo.
El capítulo empieza con un análisis multivariante que compara la composición de especies de estaciones costeras y de mar abierto; en este ejemplo, el factor principal que separa las dos comunidades es la profundidad. Después paso a la abundancia de una sola especie objetivo. En la simulación basada en la pesca de cerco mostré que los errores de un modelo corriente no se distribuyen al azar en el mapa, sino que se agrupan en ciertas zonas. Al añadir la posición al modelo, la desviación explicada pasó del 11,5% al 85,1%. La incertidumbre sobre el efecto de la temperatura superficial del mar también aumentó, porque cuando se tiene en cuenta el espacio la incertidumbre se estima de forma más honesta.
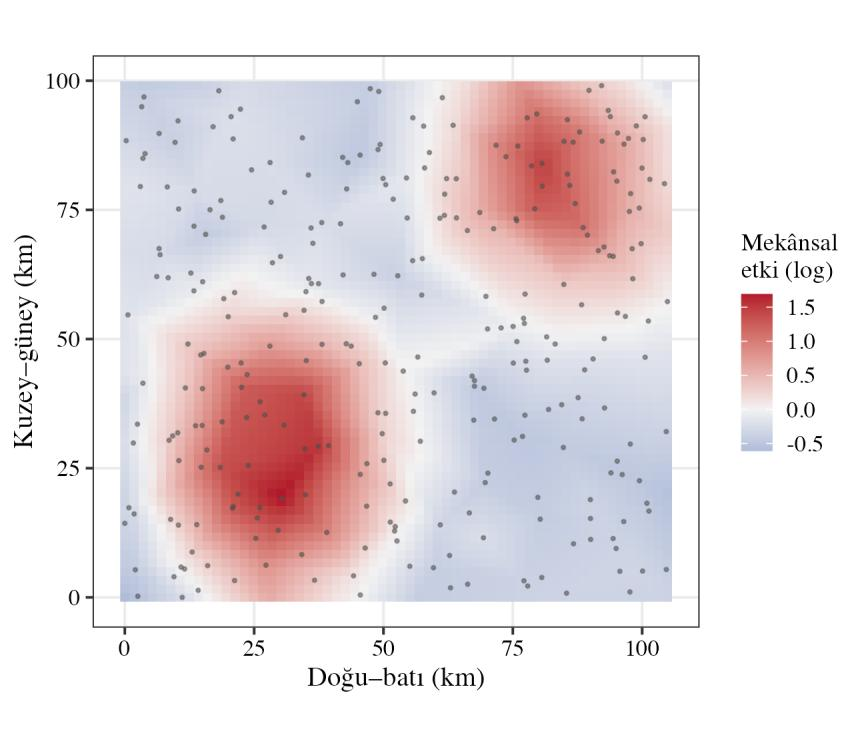
En el paso siguiente construí un campo aleatorio espacial con el paquete sdmTMB. El modelo puso claramente de manifiesto los dos caladeros de alto rendimiento de la simulación.
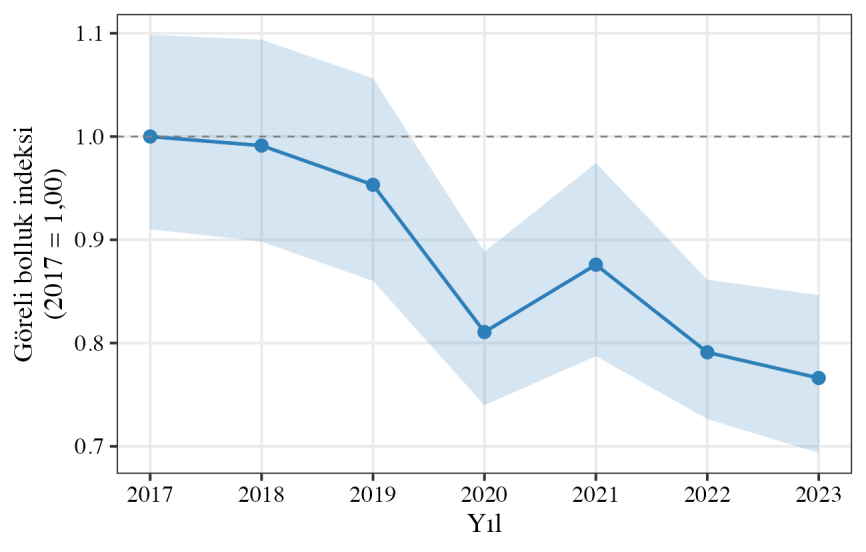
El producto principal de este modelo es un índice anual de abundancia depurado del lugar donde se hizo el muestreo. Si un año se pescó sobre todo en caladeros productivos y al año siguiente sobre todo en caladeros pobres, la media bruta de la CPUE muestra esa diferencia como si fuera un cambio de abundancia. Como el índice hace la predicción de cada año sobre la misma cuadrícula y en condiciones ambientales medias, corrige ese sesgo. En la simulación el índice bajó alrededor de un 23% entre 2017 y 2023, y cada año se presentó con su propio intervalo de confianza. Esta dirección coincide con el descenso que encontramos en 2025, junto con Balkı y colaboradores, en la pesca de cerco de la bahía de İzmir. Es justo el tipo de serie que queremos de un indicador de abundancia que vaya a entrar en la evaluación de stocks.
El lenguaje de la probabilidad está más cerca de la gestión
La última aplicación del capítulo es un modelo jerárquico bayesiano. Añadí veinte embarcaciones a los datos simulados y modelé las diferencias en su poder de pesca como un efecto aleatorio. El enfoque bayesiano da el resultado directamente como una probabilidad. En lugar de preguntar "¿es estadísticamente significativo el efecto de 2023?", podemos preguntar "¿cuál es la probabilidad de que en 2023 hubiera un descenso respecto a 2017?". La respuesta del modelo fue de alrededor del 87%. Para quien toma decisiones, esta frase se entiende mucho mejor que un valor p.
Como este modelo no incluye un campo espacial, la variabilidad que procede de la posición se mezcla con el error y los intervalos de los efectos anuales se ensanchan; la mayoría cruza el cero. Esto muestra que los métodos son más potentes no como sustitutos entre sí, sino cuando se usan juntos. El análisis multivariante define qué especies y zonas tratamos conjuntamente, el modelo espacial produce una señal de abundancia depurada del muestreo y la inferencia bayesiana convierte la incertidumbre de esa señal en probabilidades que quien decide puede utilizar.
¿Qué no sabemos todavía?
No existe una regla que diga de antemano qué método va a ganar. La elección entre aprendizaje automático y modelos clásicos depende de la estructura de los datos y de la pregunta que se plantea, y hay que volver a ponerla a prueba en cada estudio. Que los grandes modelos de lenguaje no den siempre la misma respuesta a la misma pregunta tampoco es todavía un problema resuelto para la reproducibilidad científica.
Ningún modelo puede arreglar datos malos. Los registros de posición erróneos, las definiciones de esfuerzo incoherentes o el muestreo selectivo engañan incluso al modelo más avanzado. La modelización no sustituye a los buenos datos; solo nos permite extraer más información de ellos.
Ambos capítulos están en turco:
Ceyhan T (2026). Balıkçılıkta yapay zekâ ve makine öğrenmesi uygulamaları: R ile kavramlar, yöntemler ve örnekler [Aplicaciones de inteligencia artificial y aprendizaje automático en pesquerías: conceptos, métodos y ejemplos con R]. En: İ. Daşdemir, N. Ersoy (Eds.), Ziraat, Orman ve Su Ürünleri Alanında Güncel Gelişmeler ve Tematik İncelemeler (pp. 31-66). Ankara: Platanus Publishing. ISBN 978-625-6517-39-4.
Ceyhan T (2026). Balıkçılıkta mekânsal, zamansal ve Bayesçi modelleme: R ile kavramlar, yöntemler ve örnekler [Modelización espacial, temporal y bayesiana en pesquerías: conceptos, métodos y ejemplos con R]. En: İ. Daşdemir, N. Ersoy (Eds.), Ziraat, Orman ve Su Ürünleri Alanında Güncel Gelişmeler ve Tematik İncelemeler (pp. 217-242). Ankara: Platanus Publishing. ISBN 978-625-6517-39-4.