"R ile İleri Balıkçılık Veri Analizi ve Modelleme" adlı doktora dersimde balıkçılık verisinin nasıl çözümleneceğini anlatırken iki konuya ayrıca zaman ayırıyorum. Birincisi yapay zekâ ve makine öğrenmesi, ikincisi mekânsal, zamansal ve Bayesçi modelleme. Bu iki konu için ders kapsamında hazırladığım materyalleri iki kitap bölümünde bir araya getirdim. İki bölüm de Ekim 2026'da Platanus Publishing'in yayımladığı Ziraat, Orman ve Su Ürünleri Alanında Güncel Gelişmeler ve Tematik İncelemeler kitabında çıktı.
İki bölümü de aynı düzende kurdum. Her yöntemi önce neden gerektiğiyle anlatıyorum, sonra R'da baştan sona çalışan bir örnekle gösteriyorum. Örneklerdeki veriler set.seed() ile ürettiğim benzetim verileri. Ham veriyi paylaşmamak için bu yolu seçtim, ama her benzetimi Ege'de yaptığımız gerçek bir çalışmanın yapısına göre kurdum: İzmir'deki gırgır avcılığı, Ege trol ıskartası, Azmak Deresi'ndeki mavi yengeç (Callinectes sapidus) sepetleri ve doğu Akdeniz orkinosu (Thunnus thynnus). Kodu kendi bilgisayarında çalıştıran biri bölümdeki sonuçların aynısını alıyor.
Makine öğrenmesi klasik modelleri kendiliğinden geçmiyor
İlk bölümde, rastgele orman ve artırmalı regresyon ağaçları gibi makine öğrenmesi yöntemlerini, balıkçılıkta yıllardır kullandığımız klasik modellerle aynı veri üzerinde karşılaştırdım. Başarımı her seferinde çapraz doğrulamayla, yani modelin görmediği veriyi ne kadar iyi tahmin ettiğine bakarak ölçtüm.
İzmir gırgır avcılığına dayanan CPUE örneğinde yöntemlerin tahmin hataları neredeyse aynı çıktı ve en düşük hatayı klasik GLM verdi. Trol ıskartası örneğinde GAM ile iki ağaç yöntemi yine başa baş kaldı. Mavi yengeç sepet örneğinde "yüksek av" setlerini sınıflandırırken lojistik regresyon (AUC 0,76) rastgele ormanın (0,72) biraz önünde bitirdi.
Bölümün ana mesajı şu: makine öğrenmesi klasik istatistiğin yerini alan bir üstünlük değil, onu tamamlayan bir araç. Veri düzgün bir yapıdaysa iyi kurulmuş bir GLM ya da GAM en az onlar kadar iyi tahmin yapıyor, üstelik her değişkenin etkisini okunabilir biçimde gösteriyor. Makine öğrenmesi asıl farkını, değişkenlerin karmaşık biçimde etkileştiği, ilişkinin biçimini bilmediğimiz ya da görüntü gibi çok boyutlu veriyle çalıştığımız durumlarda ortaya koyuyor.
İki yaklaşımı yan yana kullanmanın bir kazancı daha var. Gırgır örneğinde GLM deniz yüzeyi sıcaklığını anlamsız buldu, rastgele orman ise onu klorofil-a'dan sonra en önemli ikinci değişken olarak sıraladı. İlk bakışta çelişki gibi görünüyor. Oysa sıcaklık avı doğrudan değil, klorofil-a ile olan güçlü ilişkisi üzerinden etkiliyor. GLM klorofili hesaba kattığında sıcaklığa açıklayacak bir şey kalmıyor; rastgele orman bu dolaylı bilgiyi önem sıralamasına yansıtıyor. İkisine birlikte bakınca ilişkiyi daha doğru okuyabiliyoruz.
Büyük dil modelleri işi hızlandırıyor ama denetim istiyor
Bölümün son kısmında ChatGPT gibi büyük dil modellerine ve kod yazıp çalıştırabilen yapay zekâ ajanlarına yer verdim. Brown ve arkadaşlarının 2026'da yayımlanan çalışmasında bir yapay zekâ ajanına büyüme eğrisi oturtmak gibi balıkçılık biliminde sık kullanılan modelleme görevleri verilmiş. Ajan bazı denemelerde görevleri doğru tamamlamış, ama sonuçları denemeden denemeye değişmiş.
F. Ozan Düzbastılar ile birlikte yaptığımız çalışmada da benzer bir tablo gördük. ChatGPT'ye yapay resiflerle ilgili 50 soru sorduk ve yanıtları beş uzman puanladı. Yanıtların uygunluğu kullanılan komuta göre belirgin biçimde değişti; uzman puanları yedili ölçekte orta düzeyin biraz üzerinde kaldı. İki çalışmadan çıkan sonuç aynı: bu araçlar konuyu bilen birinin elinde işi hızlandırıyor, denetimsiz bırakıldığında ise güvenilmez oluyor. Bu yüzden bölümde, yönetim kararına girdi olacak hiçbir yapay zekâ çıktısının uzman denetiminden ve bağımsız doğrulamadan geçmeden kullanılmamasını öneriyorum.
Balıkçılık verisi birbirinden bağımsız değil
İkinci bölüm, makine öğrenmesinin çoğu zaman geri planda bıraktığı bir soruyla ilgileniyor: Bir tahmine ne kadar güvenebiliriz? Birbirine yakın istasyonlardan, ardışık yıllardan ya da aynı tekneden gelen gözlemler birbirine benziyor. Klasik regresyon bunları bağımsız saydığında elimizde olduğundan fazla bilgi varmış gibi davranıyoruz. Güven aralıkları daralıyor ve aslında anlamlı olmayan bir etki anlamlı görünebiliyor.
Bölüm, kıyı ve açık su istasyonlarının tür bileşimini karşılaştıran çok değişkenli bir analizle başlıyor; bu örnekte iki topluluğu ayıran asıl etken derinlik. Ardından tek bir hedef türün bolluğuna geçiyorum. Gırgır avcılığına dayanan benzetimde, sıradan bir modelin hatalarının haritada rastgele dağılmadığını, belli bölgelerde kümelendiğini gösterdim. Konumu modele kattığımda açıklanan sapma %11,5'ten %85,1'e çıktı. Deniz yüzeyi sıcaklığının etkisine ait belirsizlik de büyüdü, çünkü mekân hesaba katıldığında belirsizlik daha dürüst tahmin ediliyor.
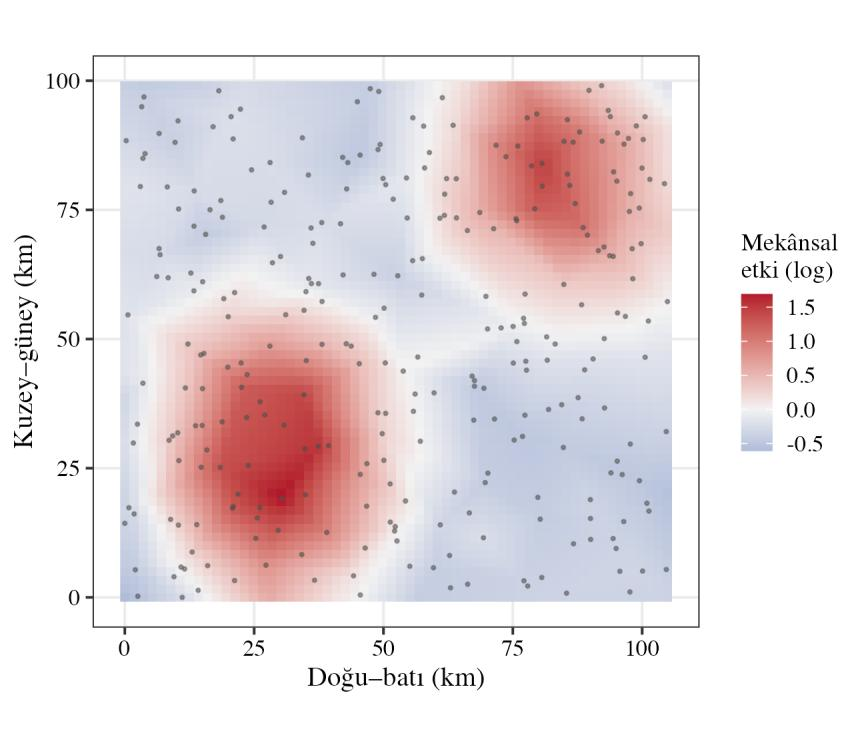
Sonraki adımda sdmTMB paketiyle mekânsal bir rastgele alan kurdum. Model, benzetimdeki iki yüksek verimli av sahasını açıkça ortaya çıkardı.
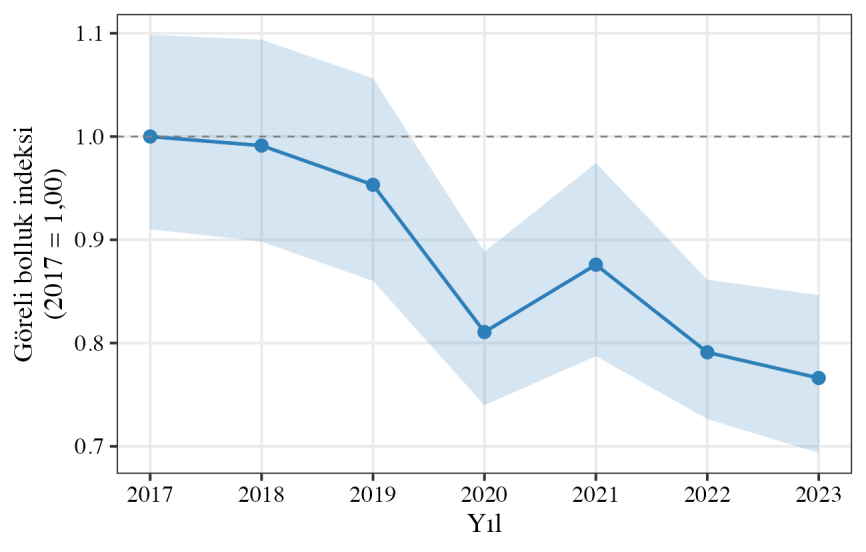
Bu modelin asıl ürünü, örneklemenin nerede yapıldığından arındırılmış yıllık bir bolluk indeksi. Bir yıl daha çok verimli sahalarda, ertesi yıl daha çok verimsiz sahalarda avlanıldıysa ham CPUE ortalaması bu farkı bolluk değişimi gibi gösterir. İndeks, her yılın tahminini aynı ızgara ve ortalama çevre koşulları üzerinden yaptığı için bu yanlılığı düzeltiyor. Benzetimde indeks 2017'den 2023'e yaklaşık %23 azaldı ve her yıl kendi güven aralığıyla raporlandı. Bu yön, Balkı ve arkadaşlarıyla 2025'te İzmir Körfezi gırgır avcılığında bulduğumuz azalışla aynı. Stok değerlendirmesine girecek bir bolluk göstergesi için istediğimiz de tam olarak bu tür bir seri.
Olasılık dili yönetime daha yakın
Bölümün son uygulaması Bayesçi hiyerarşik bir model. Benzetim verisine yirmi tekne ekledim ve teknelerin av gücü farkını rastgele bir etkiyle modelledim. Bayesçi yaklaşım sonucu doğrudan olasılık olarak veriyor. "2023 yılının etkisi istatistiksel olarak anlamlı mı?" diye sormak yerine "2023'te 2017'ye göre bir düşüş yaşanmış olma olasılığı ne?" diye sorabiliyoruz. Modelin cevabı yaklaşık %87 oldu. Bir karar verici için bu cümle bir p-değerinden çok daha anlaşılır.
Bu modelde mekânsal alan olmadığı için konumdan gelen değişkenlik hataya karışıyor ve yıl etkilerinin aralıkları genişliyor; aralıkların çoğu sıfırı kesiyor. Bu da yöntemlerin birbirinin yerine değil, birlikte kullanıldığında en güçlü olduğunu gösteriyor. Çok değişkenli analiz hangi tür ve alanları birlikte ele alacağımızı belirliyor, mekânsal model örneklemeden arındırılmış bir bolluk sinyali üretiyor, Bayesçi çıkarım da bu sinyalin belirsizliğini karar vericinin kullanabileceği olasılıklara çeviriyor.
Neyi henüz bilmiyoruz?
Hangi yöntemin kazanacağını önceden söyleyen bir kural yok. Makine öğrenmesi ile klasik modeller arasındaki seçim verinin yapısına ve sorunun ne olduğuna bağlı; bunu her çalışmada yeniden sınamak gerekiyor. Büyük dil modellerinin aynı soruya her seferinde aynı cevabı vermemesi de bilimsel tekrarlanabilirlik açısından henüz çözülmüş bir sorun değil.
Hiçbir model kötü veriyi düzeltemez. Hatalı konum kayıtları, tutarsız çaba tanımları ya da seçici örnekleme en gelişmiş modeli bile yanıltır. Modelleme iyi verinin yerini tutmuyor, sadece ondan daha çok bilgi çıkarmamızı sağlıyor.
Ceyhan T (2026). Balıkçılıkta yapay zekâ ve makine öğrenmesi uygulamaları: R ile kavramlar, yöntemler ve örnekler. İ. Daşdemir, N. Ersoy (Ed.), Ziraat, Orman ve Su Ürünleri Alanında Güncel Gelişmeler ve Tematik İncelemeler içinde (s. 31-66). Ankara: Platanus Publishing. ISBN 978-625-6517-39-4.
Ceyhan T (2026). Balıkçılıkta mekânsal, zamansal ve Bayesçi modelleme: R ile kavramlar, yöntemler ve örnekler. İ. Daşdemir, N. Ersoy (Ed.), Ziraat, Orman ve Su Ürünleri Alanında Güncel Gelişmeler ve Tematik İncelemeler içinde (s. 217-242). Ankara: Platanus Publishing. ISBN 978-625-6517-39-4.